科学の箱

科学・IT・登山の話題

機械学習

仕事で始める機械学習 – 2.機械学習で何ができるか – 分類 – ロジスティック回帰

投稿日:

ロジスティック回帰

確率を得るために

パーセプトロンの判別式により確率をとることはできない。パーセプトロンのヒンジ損失は正負のみを判断し、間違っている場合だけパラメータの更新をする。つまりぎりぎりで正解となったとしても考慮されない。またあらゆる値をとりうるために0~1となる確率は合わない。そのためにロジスティック回帰ではパーセプトロンとは異なる活性化関数と誤差関数を利用する。

シグモイド関数

実数を0~1に押し込める関数=シグモイド関数

尤度関数から交差エントロピー誤差関数

もっともふさわしいパラメータwを推定するための関数。これは各データが正解ラベルになる条件確率をすべて掛け合わす関数である。尤度関数が最も大きくなる重みwを探す。尤度関数は掛け算であり計算が面倒くさいので対数化する。さらに最小値を求める計算にするために記号を反転する。これを交差エントロピー誤差関数と呼ぶ。

正則化

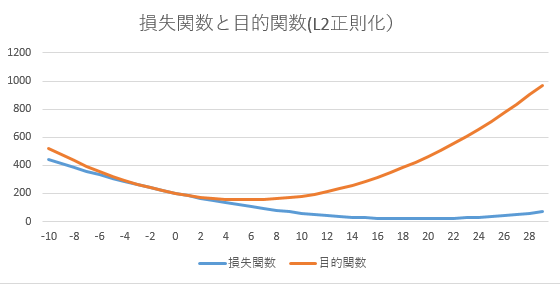
データの損失があっても、低い重みのほうが評価が高くなる(目的関数が低くなる)。

  • w = -10 ~ +30
  • 損失関数 = 0.5*(w-20)^2 + 20
  • 正則 = w^2

正則化が弱いとすべてのパラメータがモデルに組み込まれるので過学習を起こす。この結果としてすべての訓練データを通るような曲線を生成するモデルになる。それに対して正則化が強すぎるとパラメータの重みが0に近くなってしまうために直線に近づいてくる。

メタ情報

inarticle


メタ情報

inarticle


-機械学習

執筆者:


comment

メールアドレスが公開されることはありません。 * が付いている欄は必須項目です

関連記事

no image

conjoint分析の資料

マニュアル conjointパッケージ caFactorialDesign Rでconjointパッケージを利用した例 Rでコンジョイント分析 Rでコンジョイント分析 |極めて個人的なメモ コンジョイ …

no image

Core Concept in Data Analysis – Week 1

パート Data Mining Core Analysis Visualization Illustrate Data Mining data mining = patterns in data + …

no image

R Dataset – bone

データの説明 261人の子供たちから得られた年齢別骨密度。 フォーマット idnum: 識別コード age: 測定時の年齢 gender: 性別 spnbmd: 骨密度 チェック テーブル全体について …

no image

R Dataset – AirPassengers

データの説明 1949~1960年における月別飛行機搭乗者数 フォーマット このデータは時系列データであることがわかる。 > str(AirPassengers)  Time-Series [1 …

no image

irisデータを読み込んでseabornでいろいろ表示をしてみる。

data可視化ライブラリのseabornではすぐに機械学習を始められるように質が良いデータが用意されている。その中でも最も有名であるirisについてpairplotを使って可視化してみる。 ここでは以 …

2019年11月
« 10月   12月 »
 123
45678910
11121314151617
18192021222324
252627282930  

side bar top


アーカイブ

カテゴリー