irisデータを使って簡単な機械学習をしてみる。
ここで説明している内容は以下になる。
- データの読み込み、前処理
- トレインデータと検証データへの分割
- モデル選定
- モデル構築および検証
データの読み込み、前処理
手順としては以下になる。
- データの読み込み
- 目的変数作成
- 説明変数作成
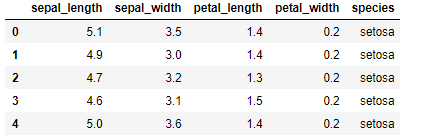
データの読み込み
データを読み込むところはseabornで説明したのと同じになる。
seaborn.load_dataset()を使う。引数に’iris’を指定する。
import seaborn as sns
iris = sns.load_dataset('iris')
iris.head()
説明変数を作成
説明変数は目的変数以外の変数をすべて使う。
DataFrame.drop()で目的変数である’species’列を削除する。
DataFrame.drop(self, labels=None, axis=0, index=None, columns=None, level=None, inplace=False, errors=’raise’)
X_iris.head()axis: 列方向の削除とするために、1を指定する。
X_iris = iris.drop('species', axis=1)
X_iris.head()
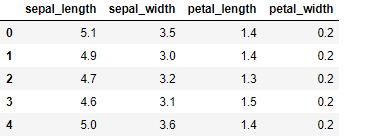
species列が削除されている。
目的変数を作成
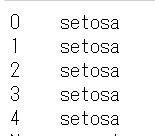
目的変数はirisの種類を表すspecies列になる。この列だけを抜き出したデータフレームを作成する。
y_iris = iris['species']
y_iris.head()
トレーニングデータと検証データへの分割
さて次にデータをトレーニング用と検証用に分割する。すべてのデータをトレーニング用にした場合過学習が起きる可能性がある。過学習ではトレーニングデータに関してはモデルは90%以上に達する程度に適合するが、別のデータを用いる場合は低い適合度しかならない。過学習を避けるためにトレーニングデータと検証用データに分割して適切な学習レベルになっているかを確認する。
データの分割はtrain_test_split()関数を利用する。
train_test_split()は下記の引数をとる
| arrays | 分割対象となるデータ |
| test_size | テストデータの割合。デフォルトは0.25 |
| train_size | 訓練用データの割合。デフォルトは1-test_size |
| random_state | ランダム変数のシード |
train_test_split()の戻り値は以下の通り。
- X_train: 訓練用データ
- X_test: 検証用データ
- Y_train: 訓練用データの正解ラベル
- Y_test: 検証用データの正解ラベル
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X_iris, y_iris,random_state=1)

X_train.shape
# (112, 4)

X_test.shape
# (38, 4)
モデル選定
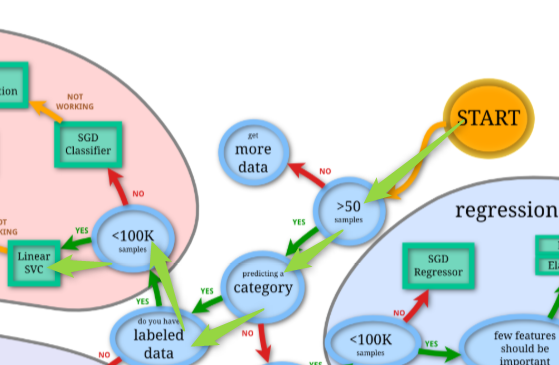
scikit-learnを利用するにあたり最も核心となるのはモデル選定である。モデルが選択できればモデル構築は数行のコードを描いて完了する。しかしモデルが正しくなければ適合率は低いままであり、求めている結果にはならない。機械学習を始めたばかりであれば、チートシートを利用するのが良い。。
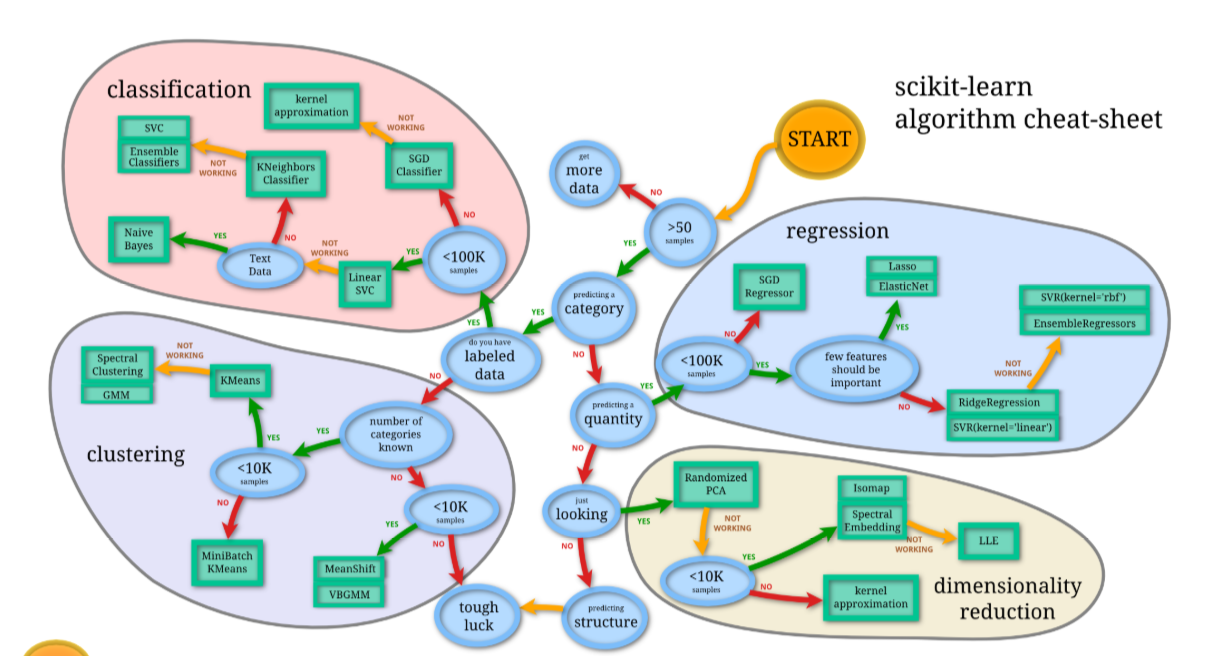
- スタートから開始する。
- サンプルの件数を確認する。50件以上ある。
X_train.shape
# (112,4)
- カテゴリデータを予測したい
- 正解ラベルを持っている
- サンプルは100k以下である。
- LinearSVCを選択する
モデルの構築および検証
前項でLinearSVCを選定した。今回は実際にモデルを構築する。
主な引数
| penalty | 罰則項、過学習の程度を調整 |
| loss | 損失関数、学習の程度を調整 |
from sklearn import svm
clf=svm.LinearSVC(max_iter=10000)
clf.fit(X_train, y_train)
max_iter = 10000を指定しないと収束せずに以下のエラーが出る。
Liblinear failed to converge, increase the number of iterations.
モデルの検証
モデルの正答率はaccuracy_scoreで求める。
sklearn.metrics.accuracy_score(y_true, y_pred, normalize=True, sample_weight=None)
パラメータは以下の通り
| y_true | 正解ラベル |
| y_pred | 予測したラベル |
from sklearn.metrics import accuracy_score
y_model = clf.predict(X_test)
ac_score = accuracy_score(y_test, y_model)
print("accuracy score: ", ac_score)
