科学の箱

科学・IT・登山の話題

機械学習

仕事で始める機械学習 – 2.機械学習で何ができるか – 分類 – ロジスティック回帰

投稿日:

ロジスティック回帰

確率を得るために

パーセプトロンの判別式により確率をとることはできない。パーセプトロンのヒンジ損失は正負のみを判断し、間違っている場合だけパラメータの更新をする。つまりぎりぎりで正解となったとしても考慮されない。またあらゆる値をとりうるために0~1となる確率は合わない。そのためにロジスティック回帰ではパーセプトロンとは異なる活性化関数と誤差関数を利用する。

シグモイド関数

実数を0~1に押し込める関数=シグモイド関数

尤度関数から交差エントロピー誤差関数

もっともふさわしいパラメータwを推定するための関数。これは各データが正解ラベルになる条件確率をすべて掛け合わす関数である。尤度関数が最も大きくなる重みwを探す。尤度関数は掛け算であり計算が面倒くさいので対数化する。さらに最小値を求める計算にするために記号を反転する。これを交差エントロピー誤差関数と呼ぶ。

正則化

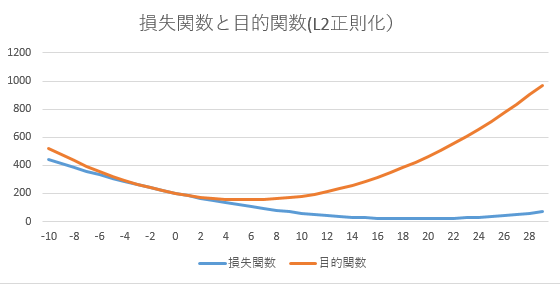
データの損失があっても、低い重みのほうが評価が高くなる(目的関数が低くなる)。

  • w = -10 ~ +30
  • 損失関数 = 0.5*(w-20)^2 + 20
  • 正則 = w^2

正則化が弱いとすべてのパラメータがモデルに組み込まれるので過学習を起こす。この結果としてすべての訓練データを通るような曲線を生成するモデルになる。それに対して正則化が強すぎるとパラメータの重みが0に近くなってしまうために直線に近づいてくる。

メタ情報

inarticle


メタ情報

inarticle


-機械学習

執筆者:


comment

メールアドレスが公開されることはありません。 * が付いている欄は必須項目です

関連記事

no image

dataanalysis-002-week3

exploratory analysis グラフの目的 データのおおよそを理解する パターンを探す モデリングを探す デバッグ コミュニケーション boxplot 値のレンジを確認する 他の値とレンジ …

no image

make_blobsで分類データを作成する

sklearnで分類学習モデルを構築する際にテストデータが必要になる。手で作成したりあらかじめ用意されたデータを使うこともできるが、make_blobsを使ってランダムデータを作成できる。 sklea …

no image

pythonのデータ分析ライブラリで遊んでみる。

こちらを参考にしてPythonのデータ分析用のライブラリをそろえてみた。 まずはお手軽にヒストグラムを書いてみる。コマンドラインからipythonを立ち上げる。 ipython –pylab &#8 …

no image

Exploratory Data Analysis

データを取得した後にやることは、データの構造化とクレンジング。それが完了したらData Exploratory Analysisに入る。 Exloratory Data Analysis(EDA)に関 …

no image

回帰と分類の違い

回帰と分類は両方とも”予測”問題である。予測とは従属変数から目的変数を明らかにする。この目的変数の種類により回帰と分類に分けられる。 回帰では連続した数値を予測する。例えば株価 …

2019年11月
月 火 水 木 金 土 日
« 10月   12月 »
 123
45678910
11121314151617
18192021222324
252627282930  

side bar top


アーカイブ

カテゴリー